Qu’ont fait vos maires ces 6 dernières années ?
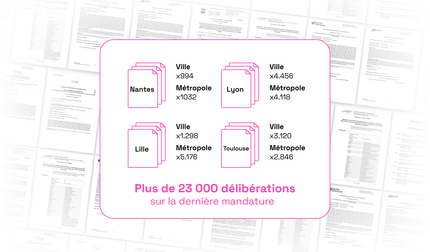
🗳️ À l’approche d’élections municipales déterminantes, nous souhaitions accompagner une rédaction d’une manière innovante et impactante. Pour Médiacités, média indépendant présent à Lille, Lyon, Nantes et Toulouse, nous avons scrapé, épluché, classifié 23 000 délibérations de conseils municipaux publiées depuis 2020. Grâce à cet explorateur de délibérations, les journalistes peuvent confronter les promesses des élu·e·s à leur bilan.
On vous raconte.
Des dizaines de milliers de PDF. Médiacités décrypte depuis des années la vie politique locale. Il y a 5 ans, nous collaborions à leur opération Radar : elle visait à décortiquer les délibérations municipales, documents essentiels du journalisme local, avec l’aide des lecteur·rice·s. Ces dernier·ère·s ouvraient une délibération et remplissaient en parallèle un formulaire pour indiquer des montants 💰, des noms de projets 🏷️, des élu·e·s présent·e·s ✅ ou absent·e·s ❌… Malgré une communauté active, ce crowdsourcing titanesque s’est essoufflé avec le temps et le foisonnement de documents…
L’IA au service de l’investigation. Si l’émergence des IA génératives pose sans cesse de nombreuses questions éthiques et environnementales, elle ouvre également la possibilité d’analyser des données très volumineuses et/ou non structurées. C’est ainsi que le projet Radar a revu le jour avec des outils d’IA ciblés sur 2 moments-clés : la transcription des compte-rendus et l’extraction d’informations.
Un projet articulé en 4 temps :
1/ Récupérer la matière “brute” des délibérations. Les ordres du jour et les compte-rendus des conseils (municipaux, métropolitains…) sont publiés en PDF sur des plateformes propres à chaque ville… Des sites hétérogènes et des données dans des formats non structurés et non lisibles par machine : nous sommes bien loin des standards de l’open data. La première étape de ce projet a donc consisté à scraper l’intégralité des compte-rendus des délibérations pour les 8 collectivités, soit plus de 23 000 documents de juin 2020 à aujourd’hui. Nous avons ensuite converti ces fichiers PDF - des scans généralement - en textes exploitables par un LLM via une conversion au format markdown à l’aide de Mistral OCR.
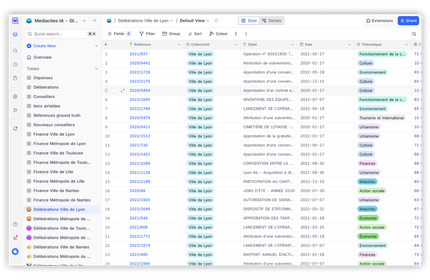
2/ Extraire des informations structurées. Ces suites de paragraphes, variant à chaque conseil municipal, sont des données textuelles non structurées, impossibles à analyser de manière massive quand on fait du datajournalisme. Pour voir des informations émerger (des tendances, des sommes étranges, la récurrence de noms de quartiers ou d’associations…), le ou la datajournaliste a besoin d’isoler au sein de ces textes des informations récurrentes, des catégories et/ou des formats identiques et ensuite, les organiser dans des tableurs (oui, on finit toujours notre vie dans des tableurs…). Pour ce faire, nous nous sommes appuyé sur une IA générative (GPT 4.1 dans notre cas) combinée au mode “structured output” de OpenAI pour forcer le LLM à respecter un format de sortie structuré.
3/ Coller aux spécificités locales et faire valider par les journalistes. Mais ce process ne peut atteindre une réelle qualité que s’il se fait main dans la main avec les rédactions. En l’occurrence, nous avons eu 2 enjeux avec elles :
- Le contexte local : les journalistes de chaque ville nous ont fourni les noms des élu·e·s, des principaux projets de la mandature… ce qui nous a permis de créer des thesaurus par ville. Sans oublier que nous avons dû travailler des prompts adaptés à chaque maquette de délibérations, donc ville par ville.
- La qualité des extractions : nous avons soumis aux journalistes les résultats de l’extraction sur 50 délibérations par collectivité où ils ont pu juger des données obtenues au regard de la délibération initiale. Grâce à ces retours précieux sur les sources d’erreurs, les améliorations potentielles, nous avons affiné nos prompts et même identifié de nouvelles données à extraire avant de lancer l’extraction sur l’ensemble des 23 000 délibérations.
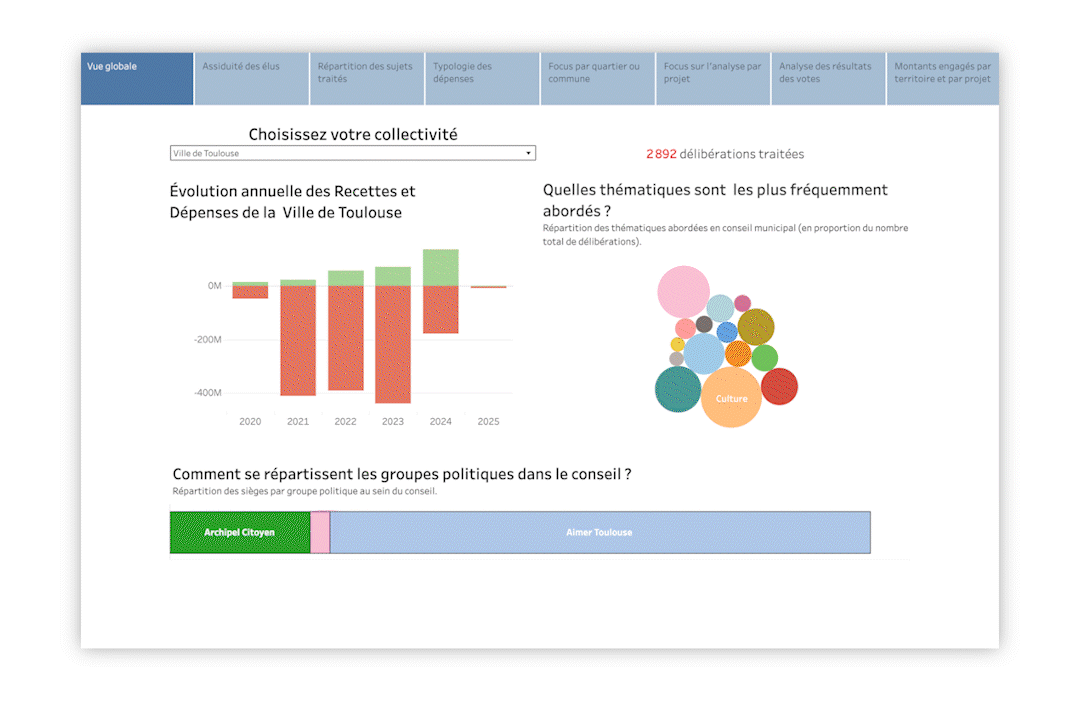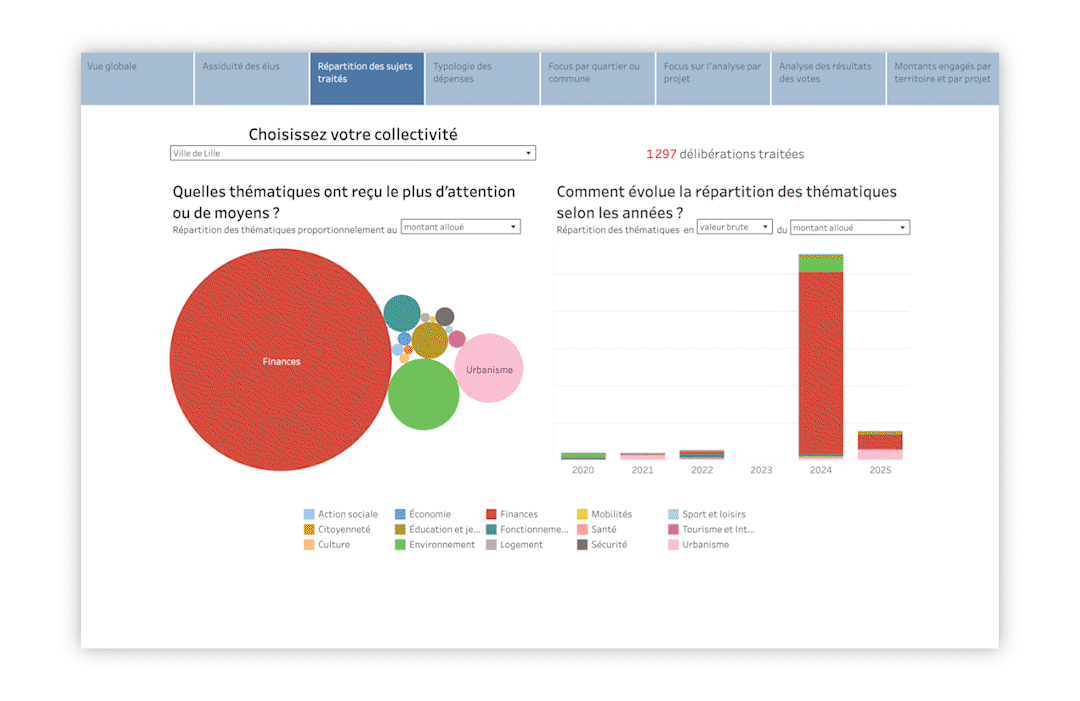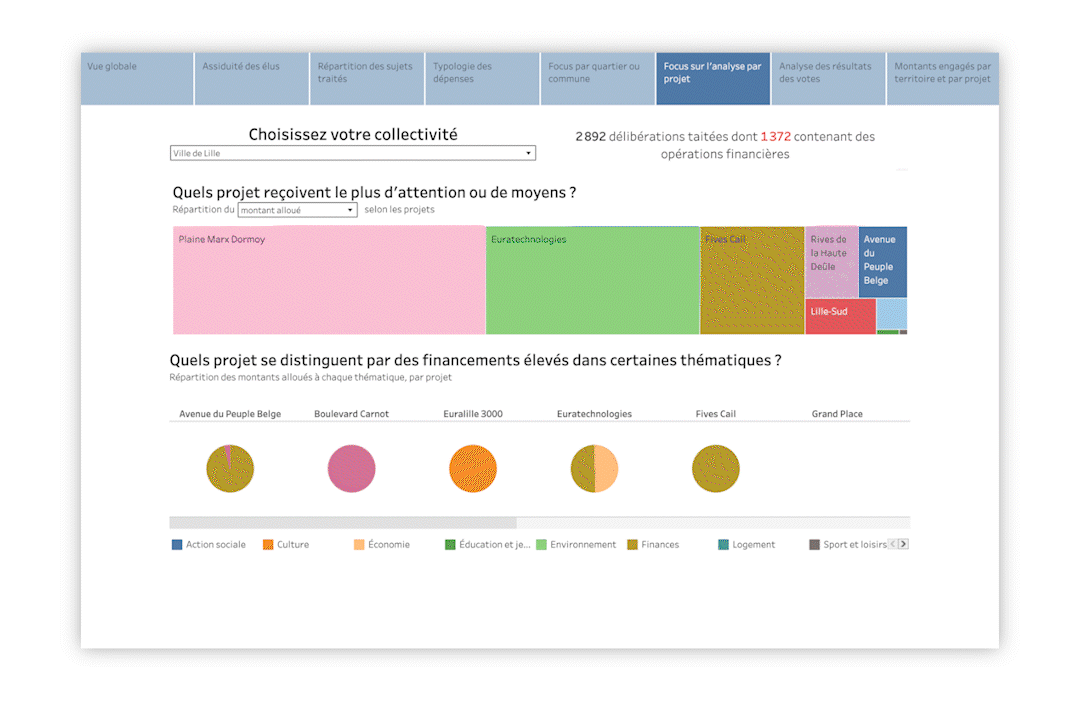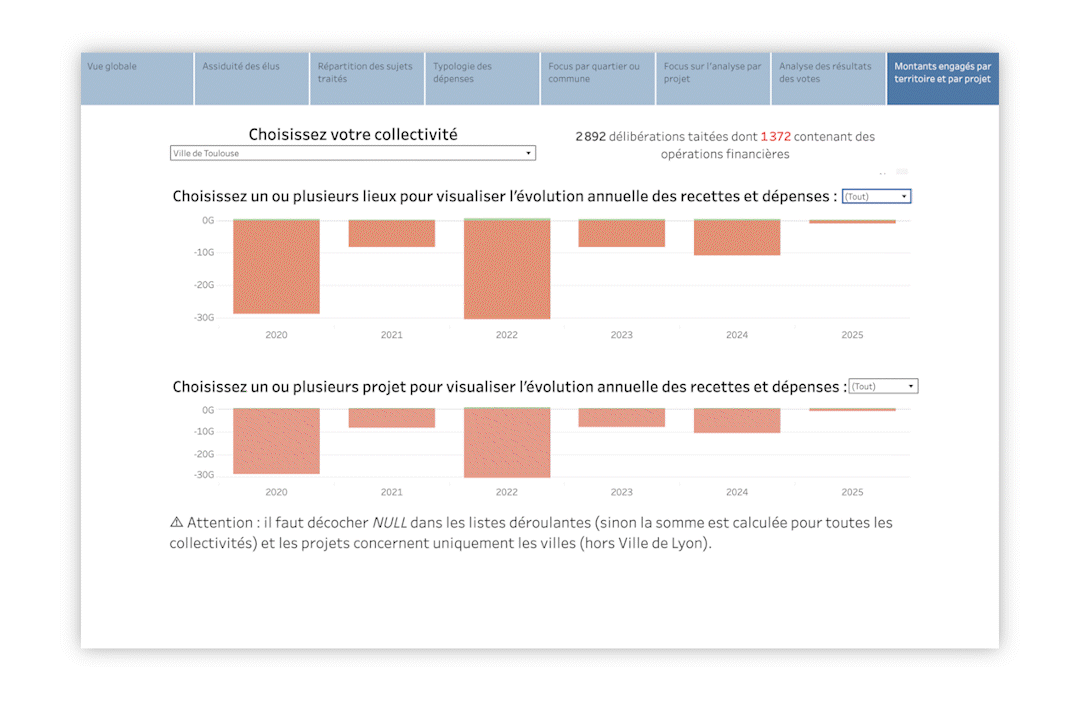
4/ Visualiser les résultats dans une interface visuelle et interactive. Comment faire en sorte que les journalistes utilisent toutes les données rassemblées dans les tableurs ? Les rendre immédiatement visibles et explorables… ce qui est un des piliers de notre activité. Les équipes de Médiacités nous ont listé les grandes questions éditoriales auxquelles ils et elles souhaitaient répondre via le projet Radar. Et nous avons configuré des dataviz répondant à ces angles, ville par ville, sur l’outil Tableau - qui permet de réaliser des dashboards flexibles.
Retour d’expérience avec Benjamin Peyrel, co-fondateur de Médiacités et directeur de la rédaction
“Bénéficier de cette base de données issue des délibérations municipales nous a permis de vérifier au plus près les promesses des candidats. Cet outil puissant a aussi permis d’identifier de nouveaux sujets, de repérer des accumulations de sommes qui passent inaperçues lorsqu’elles arrivent au fil de l’eau… L’utilité journalistique de cette nouvelle démarche est de bénéficier d’un thermomètre innovant de l’activité municipale. Nous avons donc posé une pierre importante pour la prochaine mandature que nous pourrons suivre au plus près.”
✅ Retrouvez les enquêtes de Médiacités, menées en partenariat avec MOB, publiées sur les municipales.